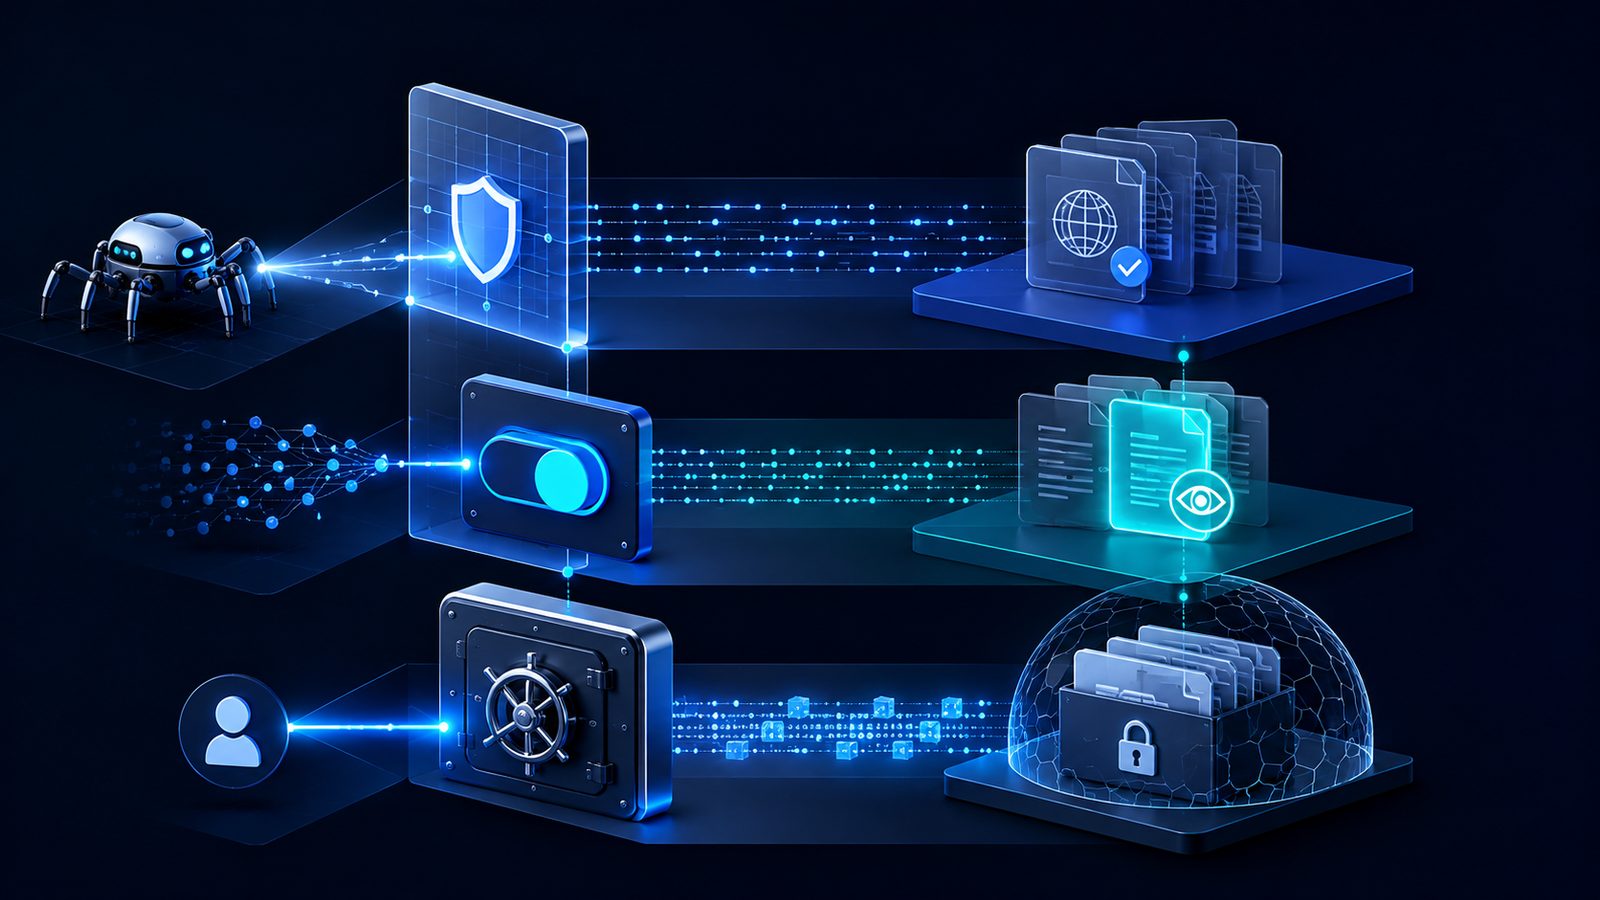
不想公开的内容不能只依赖搜索指令保护。robots.txt控制请求,noindex表达索引意图,登录与权限控制才用于限制未授权访问,三者解决的风险不同。
可访问和可索引是两个问题
若希望爬虫读取noindex,页面通常需要先允许其访问;若内容敏感,则应从服务器权限上阻止未授权用户,而不是等待搜索系统遵守标记。
在robots.txt阻止页面后再添加noindex并不一定形成“双重保险”,抓取方可能根本看不到页面内规则。
敏感资料必须依靠权限
从信息公开级别出发选择控制方式,发布前在未登录环境和响应头层面验证。
客户资料库需要账号授权,不能因为robots禁止路径就认为内容已经保密;一个公开活动预览页若暂不希望进入搜索,可按目标平台支持方式使用noindex,但页面本身仍可能被拿到。先区分访问对象,才能选择安全控制或索引偏好。
验收可从每种内容级别抽取一个网址,检查未登录访问、响应头、meta、robots、Canonical和Sitemap。若爬取被阻止,平台可能无法读取页面上的索引指令;若敏感文件有可猜地址,移除索引也不解决泄露。冲突必须按最初目标逐层修正。
按内容等级配置三层控制
1. 给内容定级
区分公开内容、可分享但不希望搜索、仅客户可见和内部敏感资料。
2. 配置索引规则
公开但需暂缓索引的页面按目标平台支持方式使用meta或X-Robots-Tag。
3. 实施真正权限
客户与内部资料使用身份验证、授权和服务器访问控制,不暴露可猜测下载地址。
4. 检查组合冲突
确认robots、页面meta、响应头、Canonical和Sitemap没有表达相反目标。
从代表网址查信号冲突
- [ ] 公开、可分享但不希望搜索、仅客户可见和内部敏感资料已经分级,负责人确认目标。
- [ ] 需要暂缓索引的公开页按目标平台支持方式设置meta或响应头,复查时可读到该指令。
- [ ] 客户和内部内容依靠身份验证、授权与服务器控制,未把robots当作保密工具。
- [ ] robots、页面meta、响应头、Canonical与Sitemap逐页核对,不存在相互冲突的公开意图。
先决定谁可以访问,再决定公开页面是否参与索引。访问权限和索引偏好属于两个层次,验收记录也应分开。
事实边界
noindex与robots实现因搜索系统而异,且都不是保密机制。涉及个人信息、商业秘密和客户资料时,应采用正式安全与权限方案。