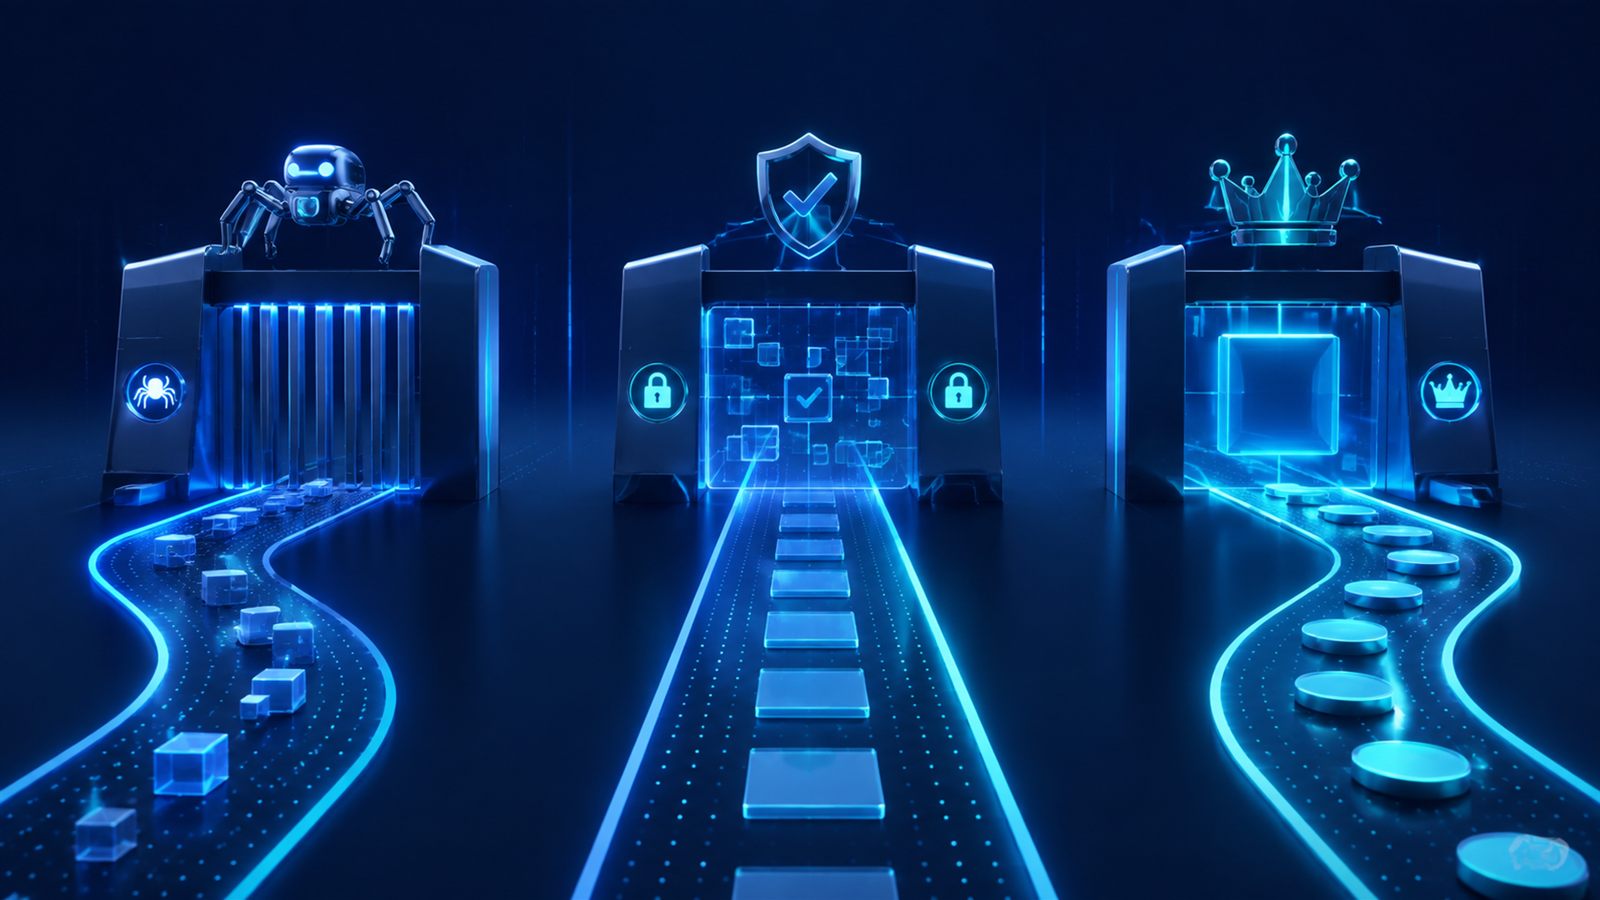
按抓取控制、索引意愿和重复归一化区分三种机制,避免互相抵消。
robots.txt管理特定爬虫能否请求路径;noindex表达页面不应进入支持该指令的索引;canonical用于相似页面中提示首选网址。需要保密的内容应使用访问控制,不能依靠这些公开网页指令。
先写清页面到底想要什么
先写明页面目标:要不要访问、要不要索引、是否存在重复版本,再选择机制。变更后检查状态码、响应头、HTML和实际抓取结果;不要同时阻止抓取又期待系统读取页面中的noindex。
要不要让爬虫访问、要不要进入索引、是否存在重复版本,是三个不同问题。robots.txt主要管理请求路径,noindex表达索引意愿,Canonical提示相似页面的首选URL;保密页面则应使用权限控制。
组合错误比缺少配置更危险
建立规则清单和测试URL,记录修改前后、适用爬虫、上线时间与验证结果。对关键目录做自动回归,防止模板或环境配置误伤正式页面。
如果先用robots阻止页面,再期待爬虫读取页面里的noindex,就可能达不到目的;不想公开的内容仅设Canonical也无法阻止访问。每次配置前先用测试URL写出预期,再检查状态码、响应头与HTML。
平台边界需要逐一登记
- 先定义访问与索引目标。
- 区分抓取索引规范化。
- 保密内容使用权限控制。
- 准备测试URL验证规则。
- 记录平台适用范围。
Google和OpenAI公开文档解释各自产品,不能直接套到豆包或其他系统。规则清单应注明适用爬虫、上线日期和验证结果,对关键目录做回归;发现异常时先报告可观察现象,不猜测内部索引状态。
用测试URL验证三类控制是否各司其职
robots.txt管理抓取访问,noindex表达不进入索引的意图,Canonical声明近似内容的首选版本。保密信息不能依赖robots.txt保护,因为网址仍可能通过其他入口暴露;应使用登录、访问控制或移除公开资源。
准备三个测试URL:允许抓取的正式页、需要排除索引但可访问的页面、以及有首选版本的重复页。分别检查响应状态、robots规则、页面或响应头中的noindex、Canonical目标和内部链接。若robots阻止了需要读取noindex的页面,应先修正组合逻辑。记录每项规则适用的平台文档和测试日期,第三方是否采纳则作为后续观察状态,不写成部署完成的必然结果。
测试还应覆盖HTTP响应头,因为PDF或其他非HTML资源可能通过头部设置索引指令。规则修改后要重新访问实际URL,不能只阅读配置文件。若平台文档对指令支持范围不同,页面策略需按目标渠道分别记录。