公司已经注册,官网也能打开,为什么在AI搜索里仍然找不到?常见的排查方向不是继续增加关键词,而是检查企业信息在“能否访问、能否归入正确主体、能否回答问题、能否被其他资料核验”这几层中是否存在缺口。
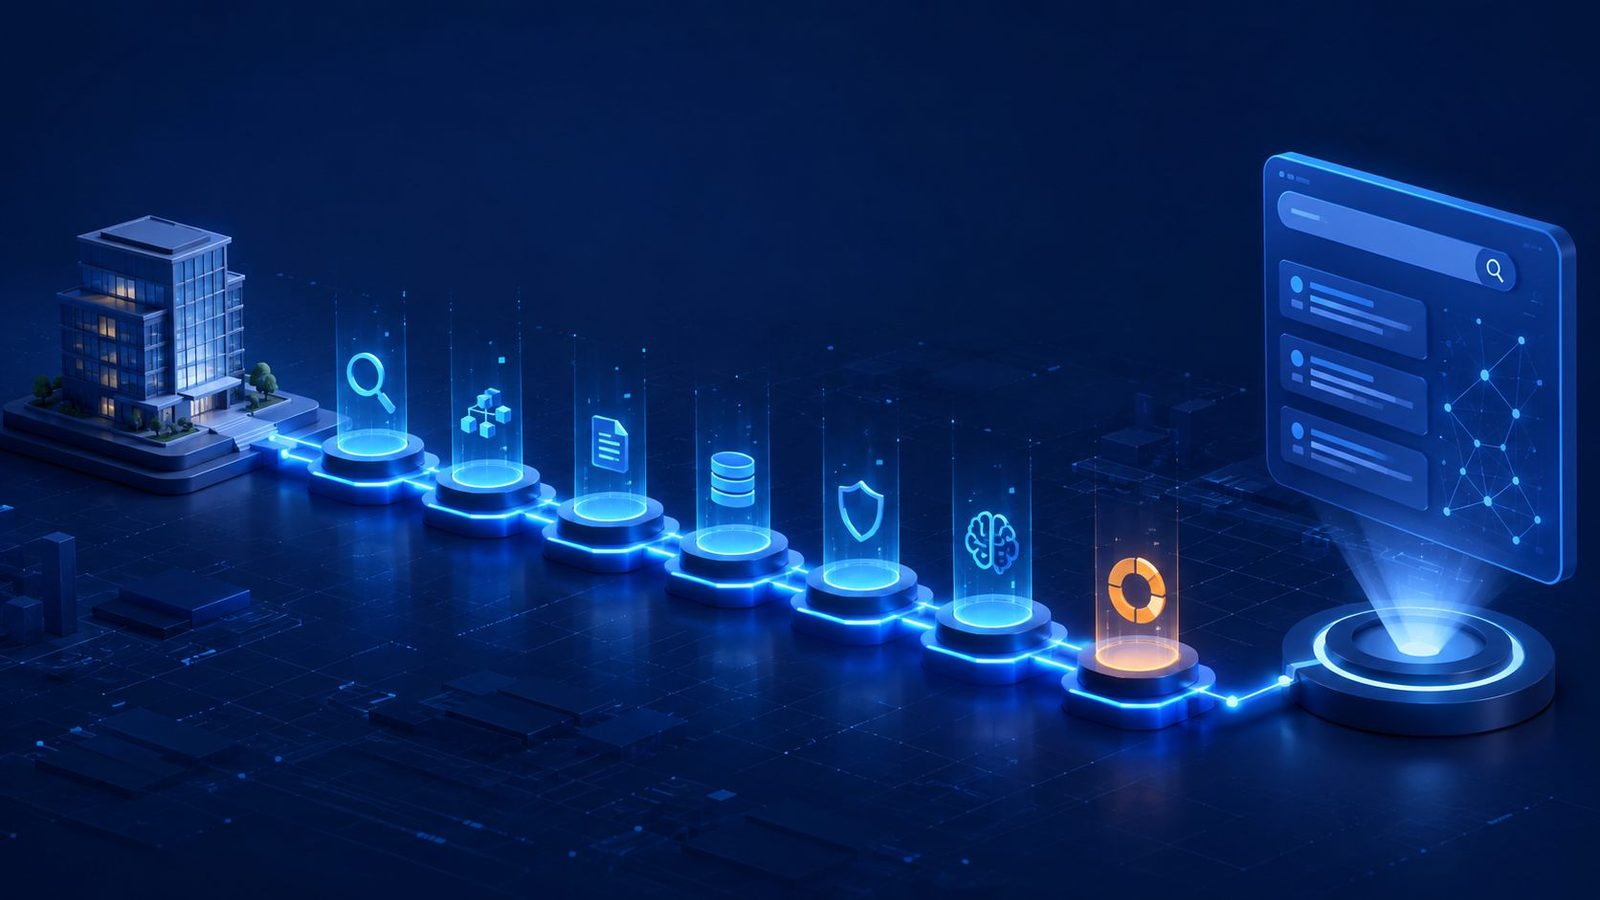
不能从一次提交或一次测试推断页面会在固定时间进入所有AI答案。企业更适合按照下面七项逐层检查,先找到问题所在,再决定要改技术、内容还是资料。
1. 重要页面能否直接访问
先用未登录浏览器打开首页、关于我们、核心服务、案例和联系页面,确认页面返回正常、没有验证码、登录墙或持续跳转。正文不能只在海报里,也不要等到复杂交互完成后才出现。
同时检查robots.txt有没有误拦核心目录。它主要用于控制爬虫可以请求哪些网址,不等于“是否进入索引”的总开关;Google的官方说明也明确区分了robots与noindex。S03
2. 网址是否被发现和抓取
新页面需要入口。网站导航、栏目页、相关文章链接和Sitemap都能帮助系统发现网址。Sitemap适合告诉爬虫有哪些新页面或更新页面,但它不是收录保证。S02
这里要把“能打开”“已经抓取”和“已经收录”分开。服务器日志或站长工具出现抓取记录,只能说明爬虫曾访问网址,不能证明页面已进入可检索数据库。
3. 页面是否具备进入索引的条件
检查页面标题和正文是否一致、内容是否过少、相似页面是否太多、Canonical是否指向正确网址,以及页面是否误加noindex。如果同一篇内容存在多个网址,应选定稳定主网址,并让内链、Sitemap和Canonical口径一致。S04
Google把抓取、索引和结果呈现列为不同阶段,也明确不保证每个合规页面都一定被抓取、索引或展示。S01 这套文档不能代替豆包等平台的内部规则,但很适合帮助企业避免把技术阶段混为一谈。
4. 公司全称与品牌是否能对应
很多企业官网只写法定全称,短视频账号只写品牌简称,地图地点又使用门店名,三个页面之间没有说明关系。机器可能无法判断它们是否属于同一主体。
建议在官网和主要公开账号中明确:
- 公司法定全称;
- 对外品牌名称;
- 品牌与运营主体的关系;
- 所在城市、官网域名和统一联系方式;
- 核心业务与明确服务区域。
这些事实不需要在每个页面机械重复,但不能相互矛盾。
5. 官网是否真正回答客户问题
“专业、领先、值得信赖”无法说明公司到底提供什么。核心服务页至少要回答:服务适合谁、具体做什么、怎么推进、交付什么、如何验收、有什么限制。
知识文章则应各自解决一个完整问题。例如“为什么AI搜索不到企业”“GEO项目怎样验收”“选择服务商看什么”。当正文能够被独立理解,页面才具备被检索和引用的实际信息价值。
6. 是否存在可核验的证据
官网和企业自媒体负责说明“我们是谁、我们做什么”;真实案例、客户授权材料、合作方公开信息、资质文件和行业活动记录,可以补充“这些事实如何验证”。
证据的重点是相关、真实和能够回到原页面,而不是账号数量。未获客户授权的名称和结果不要公开;无法核验的排行榜、奖项和增长数字也不要写进官网。
7. 是否给新内容留下观察时间
页面上线后需要经历发现、访问、处理和后续检索。不同平台节奏不同,外部团队无法承诺固定天数。每天换问题、换账号测试,反而会让结果难以比较。
更好的做法是确定一组品牌问题、业务问题和选择问题,按固定平台、联网状态和时间间隔记录。若品牌全称仍找不到,先修复发现、索引和主体信息;若品牌能被介绍但服务问题不出现,再完善问题内容与证据。
从一张排查表开始
第一次检查可以只记录五列:网址、访问状态、索引状态、页面主题、下一步动作。技术问题解决后,再建立公司标准资料表和内容问题库。
GEO不能把不可控的平台答案变成固定广告位。企业能够控制的是:公开页面是否稳定,事实是否一致,内容是否有用,证据是否真实,监测是否连续。把这几项做好,才有条件讨论后续的品牌提及和引用变化。
说明:本文中的Google资料用于解释公开的搜索抓取与索引概念,不代表豆包或其他AI平台采用完全相同的机制。参考资料见页面末尾。